Lecture 12. 内存管理与缓存策略
https://blog.csdn.net/dongyanxia1000/article/details/53392315https://www.cnblogs.com/gintaberry/p/4145333.html
访问局部性 locality of reference
访问局部性(英语:Locality of reference)指的是在计算机科学领域中应用程序在访问内存的时候,倾向于访问内存中较为靠近的值。
访问局部性分为两种基本形式,一种是时间局部性,另一种是空间局部性。时间局部性指的是,程序在运行时,最近刚刚被引用过的一个内存位置容易再次被引用,比如在调取一个函数的时候,前不久才调取过的本地参数容易再度被调取使用。空间局部性指的是,最近引用过的内存位置以及其周边的内存位置容易再次被使用。空间局部性比较常见于循环中,比如在一个数列中,如果第3个元素在上一个循环中使用,则本次循环中极有可能会使用第4个元素。第三种为循序局部性。
局部性是出现在计算机系统中的一种可预测行为。系统的这种强访问局部性,可以被用来在处理器内核的指令流水线中进行性能优化,如缓存,内存预读取以及分支预测。
- Temporal 时间:If an item is referenced, it will tend to be referenced again soon
- Spatial 空间:an item is referenced, nearby items will tend to referenced soon.
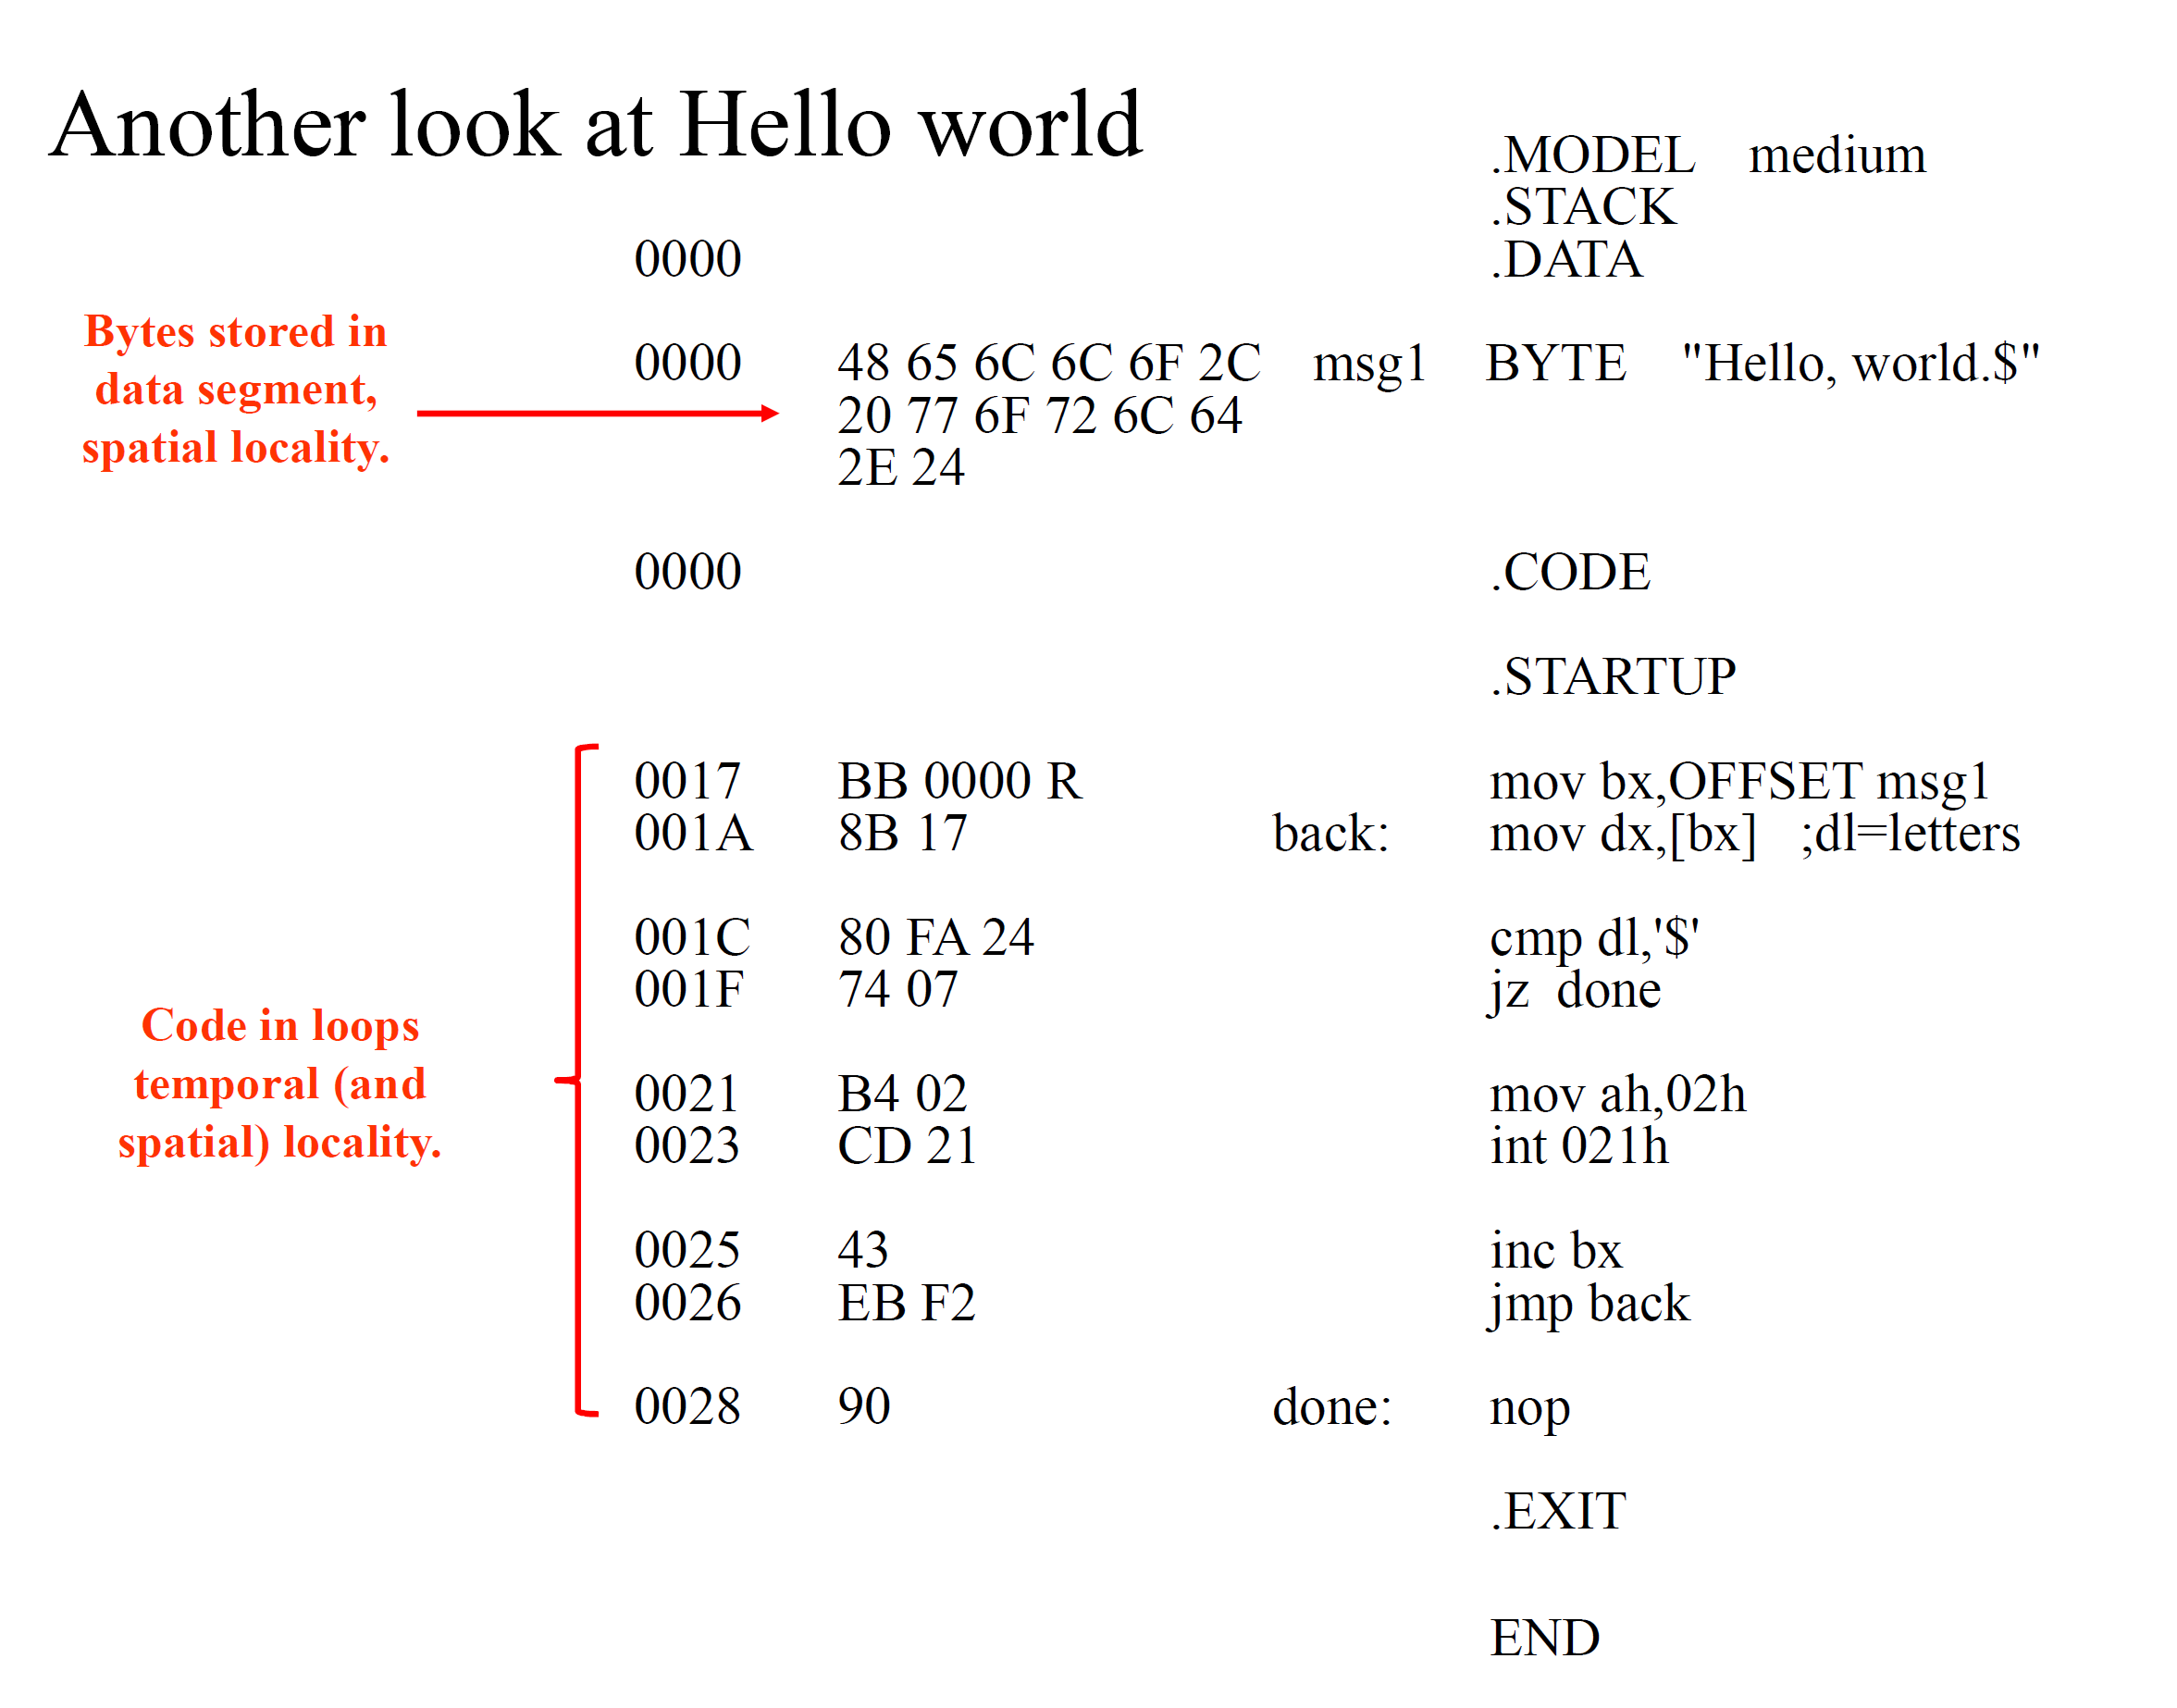
像这个 hello world 程序,msg1 部分就是空间局部性,循环部分的代码既时间局部性又有空间局部性:
缓存 Cache
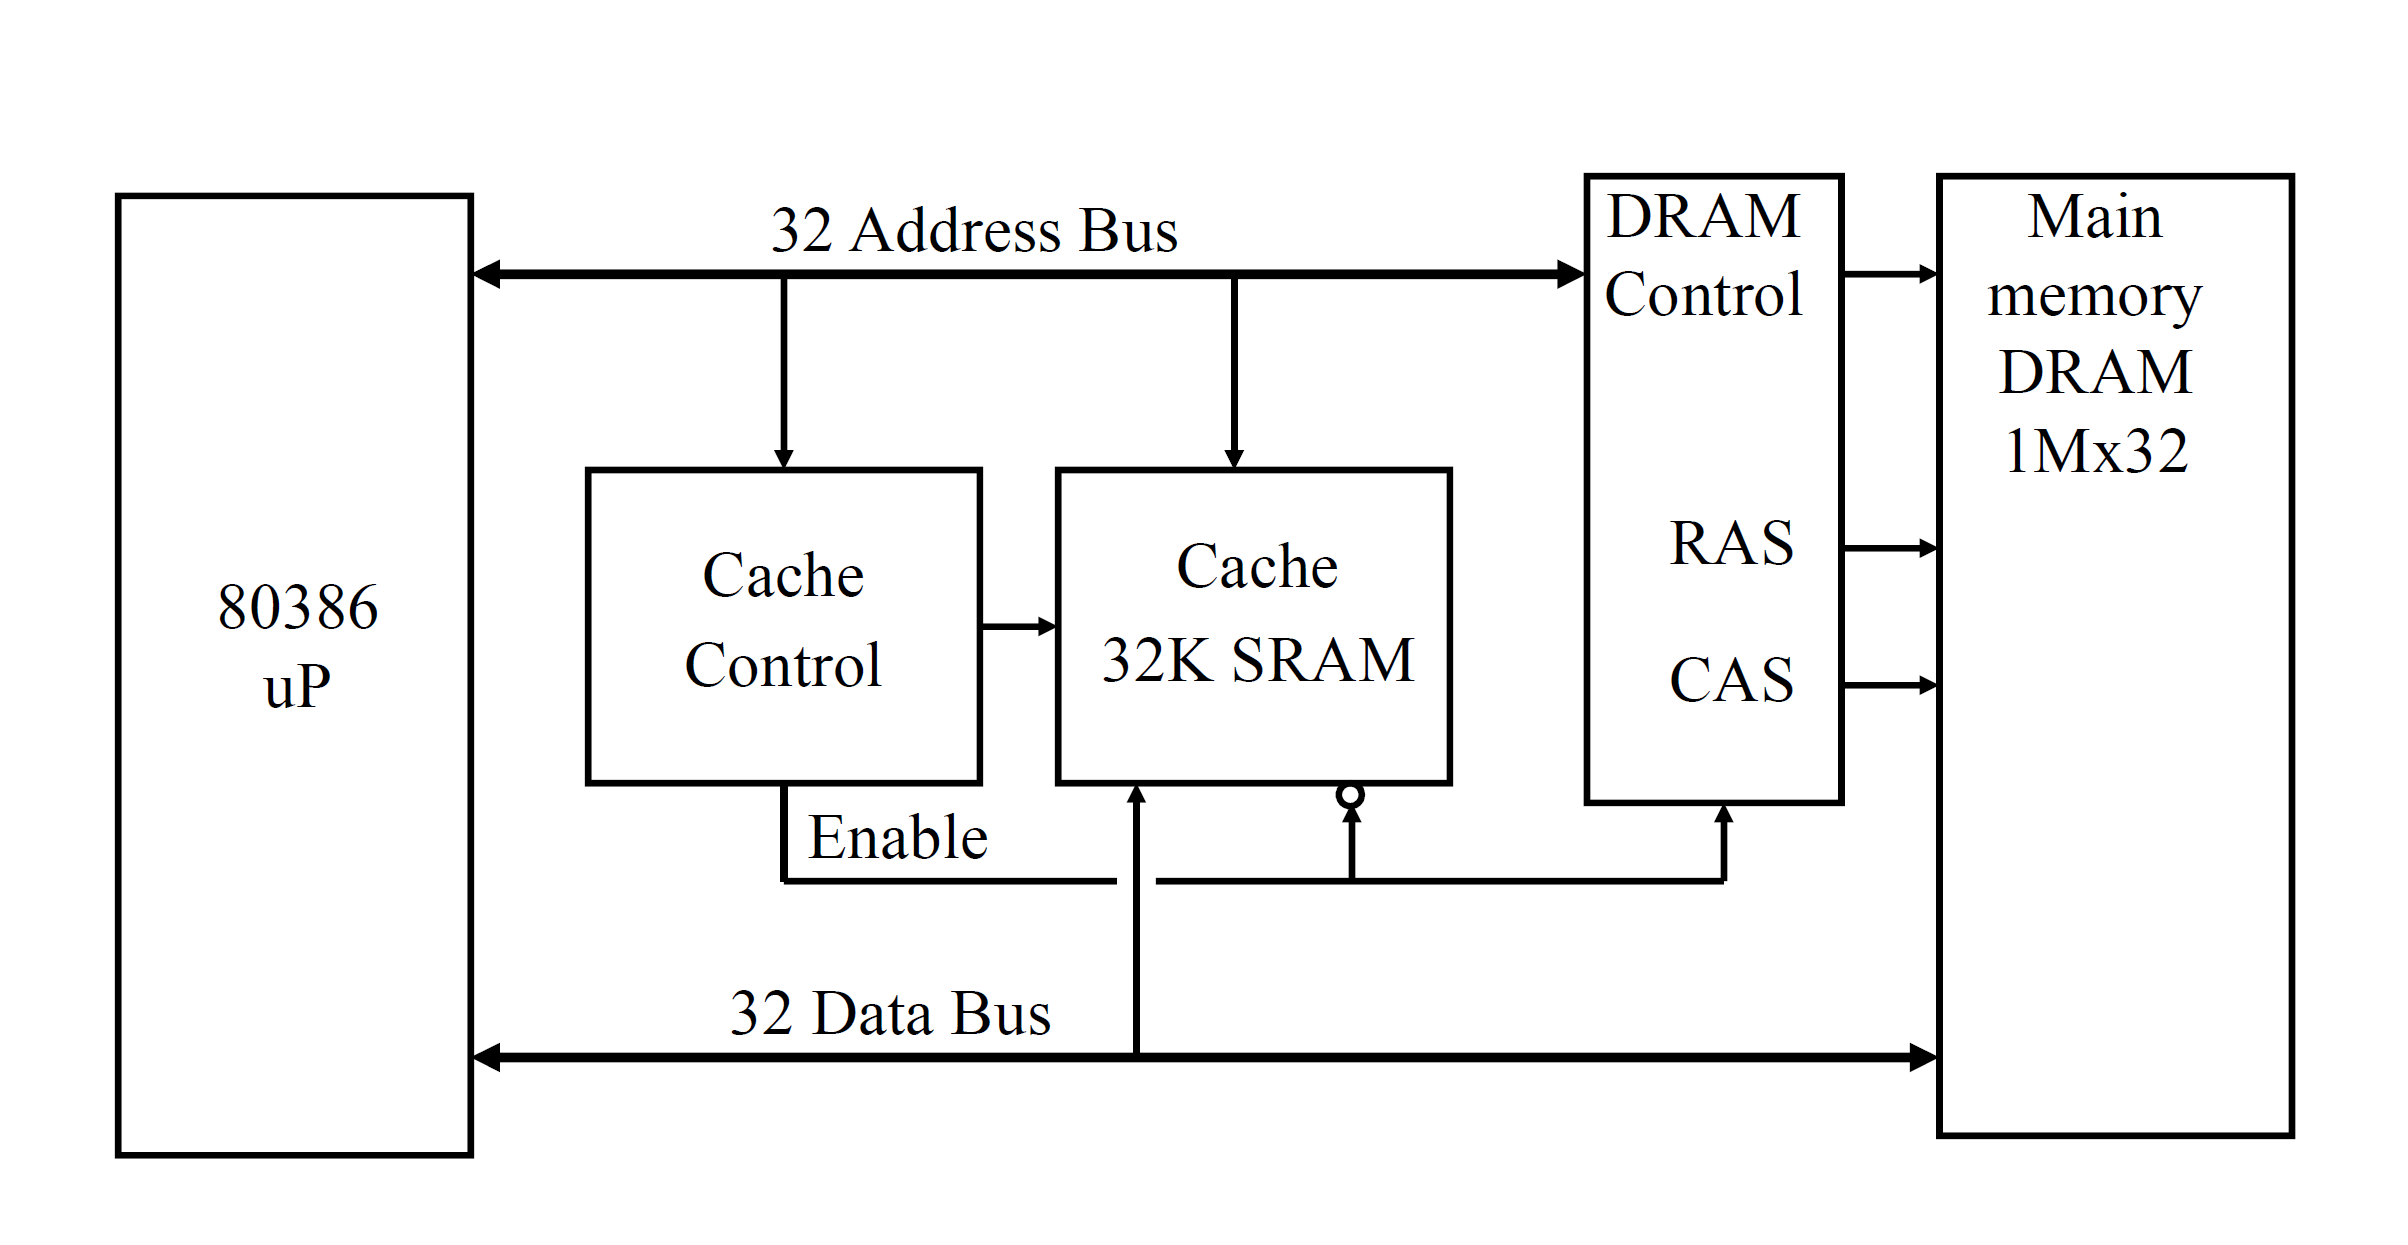
当处理器需要内存当中的数据,就会先查找缓存。缓存是 SRAM,很快,主存是 DRAM,慢。如果缓存没有,就会去主存里面找,找到之后就放进缓存,留着备用。然而,存入缓存这个步骤本身,挺慢的。
有一个叫做 hit-rate 的东西,定义为 ,这是用于衡量缓存效率的重要指标。一般这个值应当在 90% 左右。
根据经验,如果 hit 了(缓存里有),那么只需要 1~4 个时钟周期。如果 miss 了(缓存里面没有),那就需要 8~32 个时钟周期。而 miss 的概率一般是 1%~20% 左右。
缓存模式
没搞明白,可能有一些错误
- 直接映射 Direct Mapped Cache:缓存对应了主存当中的某个页。如果频繁切换访问的页,那么这种方式就会很慢(thrashing)
- 二路相联映射 Two-Way Set Associative,用两块分开的缓存。这样一来,如果频繁切换访问的页,thrashing 的概率会有所降低
- 全相联映射 Fully Associative,用的时候随便找个缓存位置放进去。但缺点就是如果要查找是否存在,就要遍历一遍缓存(类似停车场,随便停,但是记不住停在哪里,找半天)
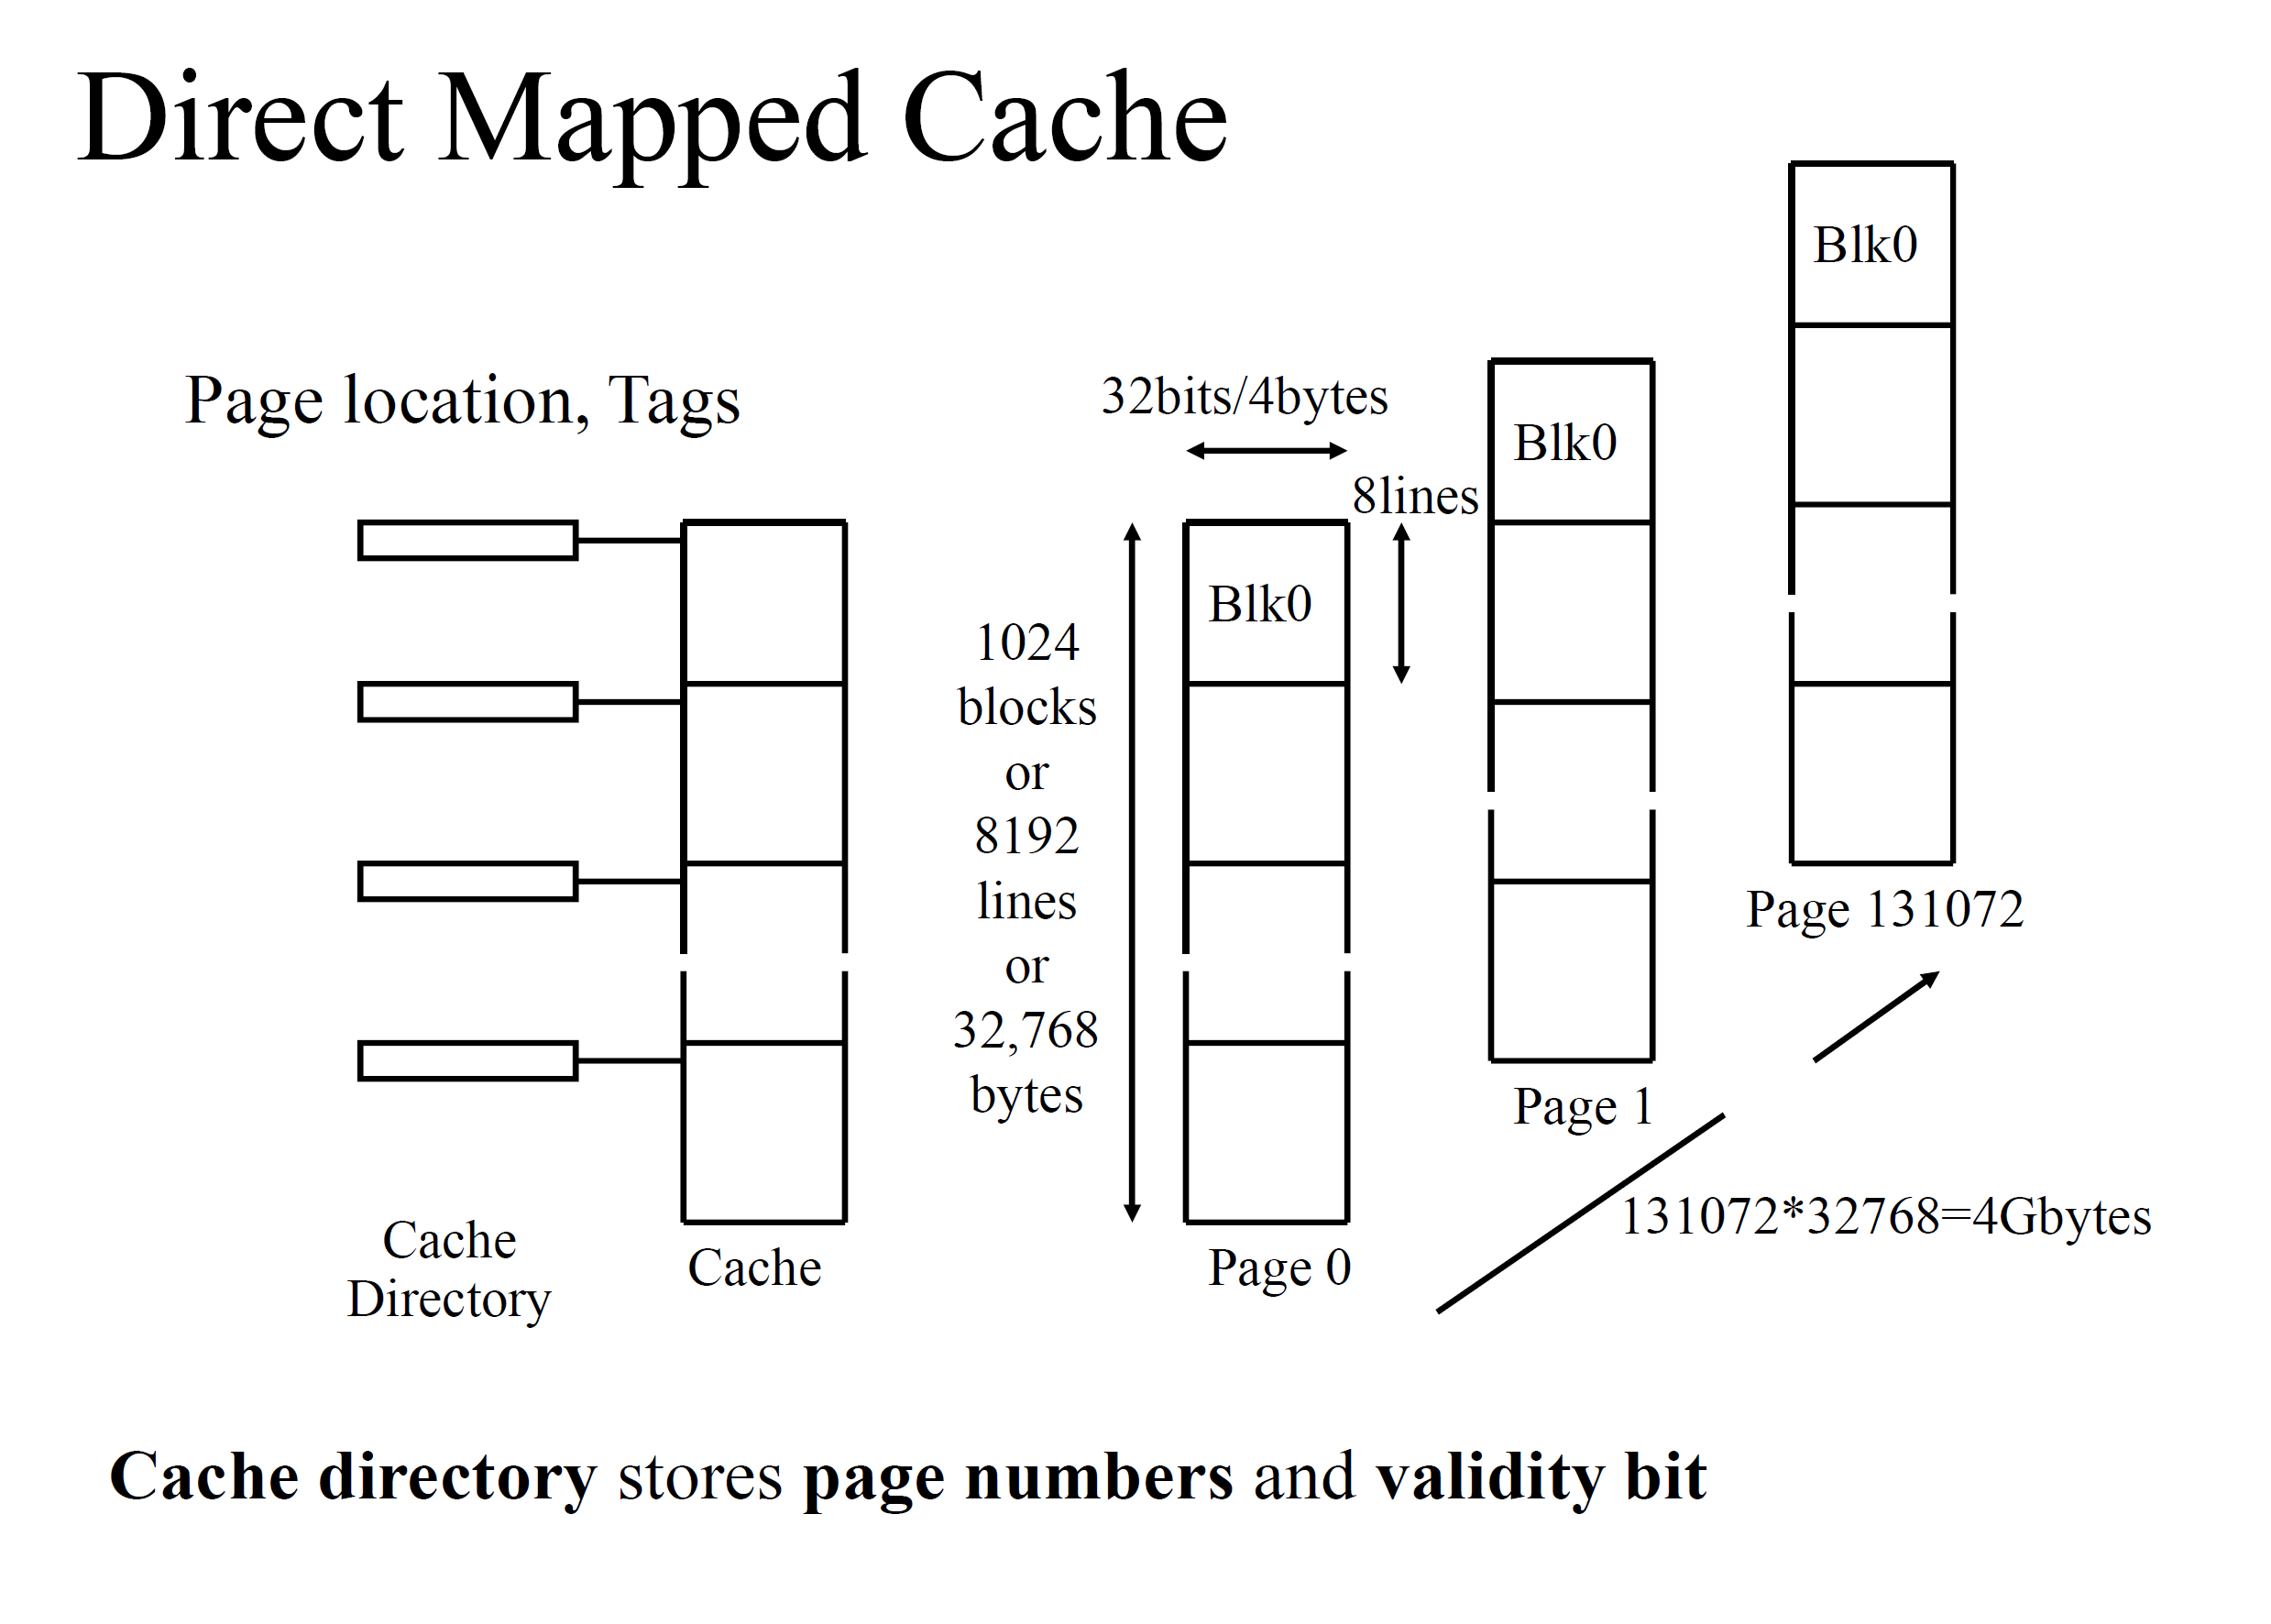
直接映射 Direct Mapped Cache
- 80386,地址总线 32 位,寻址大小 4GB。
- 80386 的缓存包含 8192 条线,每条线都是 4 字节的,所以总共有 32768 个 byte。
- 每条线对应到一个页,那么 4G 的内存就分成了 131072 个页,每页大小 32k
- 由于一共有 131072 个页,所以 32 位地址的高 17 位可以确定页编号,也可以用来判断缓存当中是否有这个数据(还要结合一下 tag bit 判断是否是最新数据)
- 如果 hit 了,就直接从缓存里面拿
- 如果没 hit,就让 cache controller 从 dram 里面拿出来存进 cache
对于 80386 的 32 位的地址总线,因为每个页是 32k 字节或 8k 个线或 1k 个块:
- A15-A31: Set the page in main memory
- A5-A14: Set the block number in cache
- A2-A4: Set the line number in the block
- A0-A1: Specific bytes in the line
Thrashing
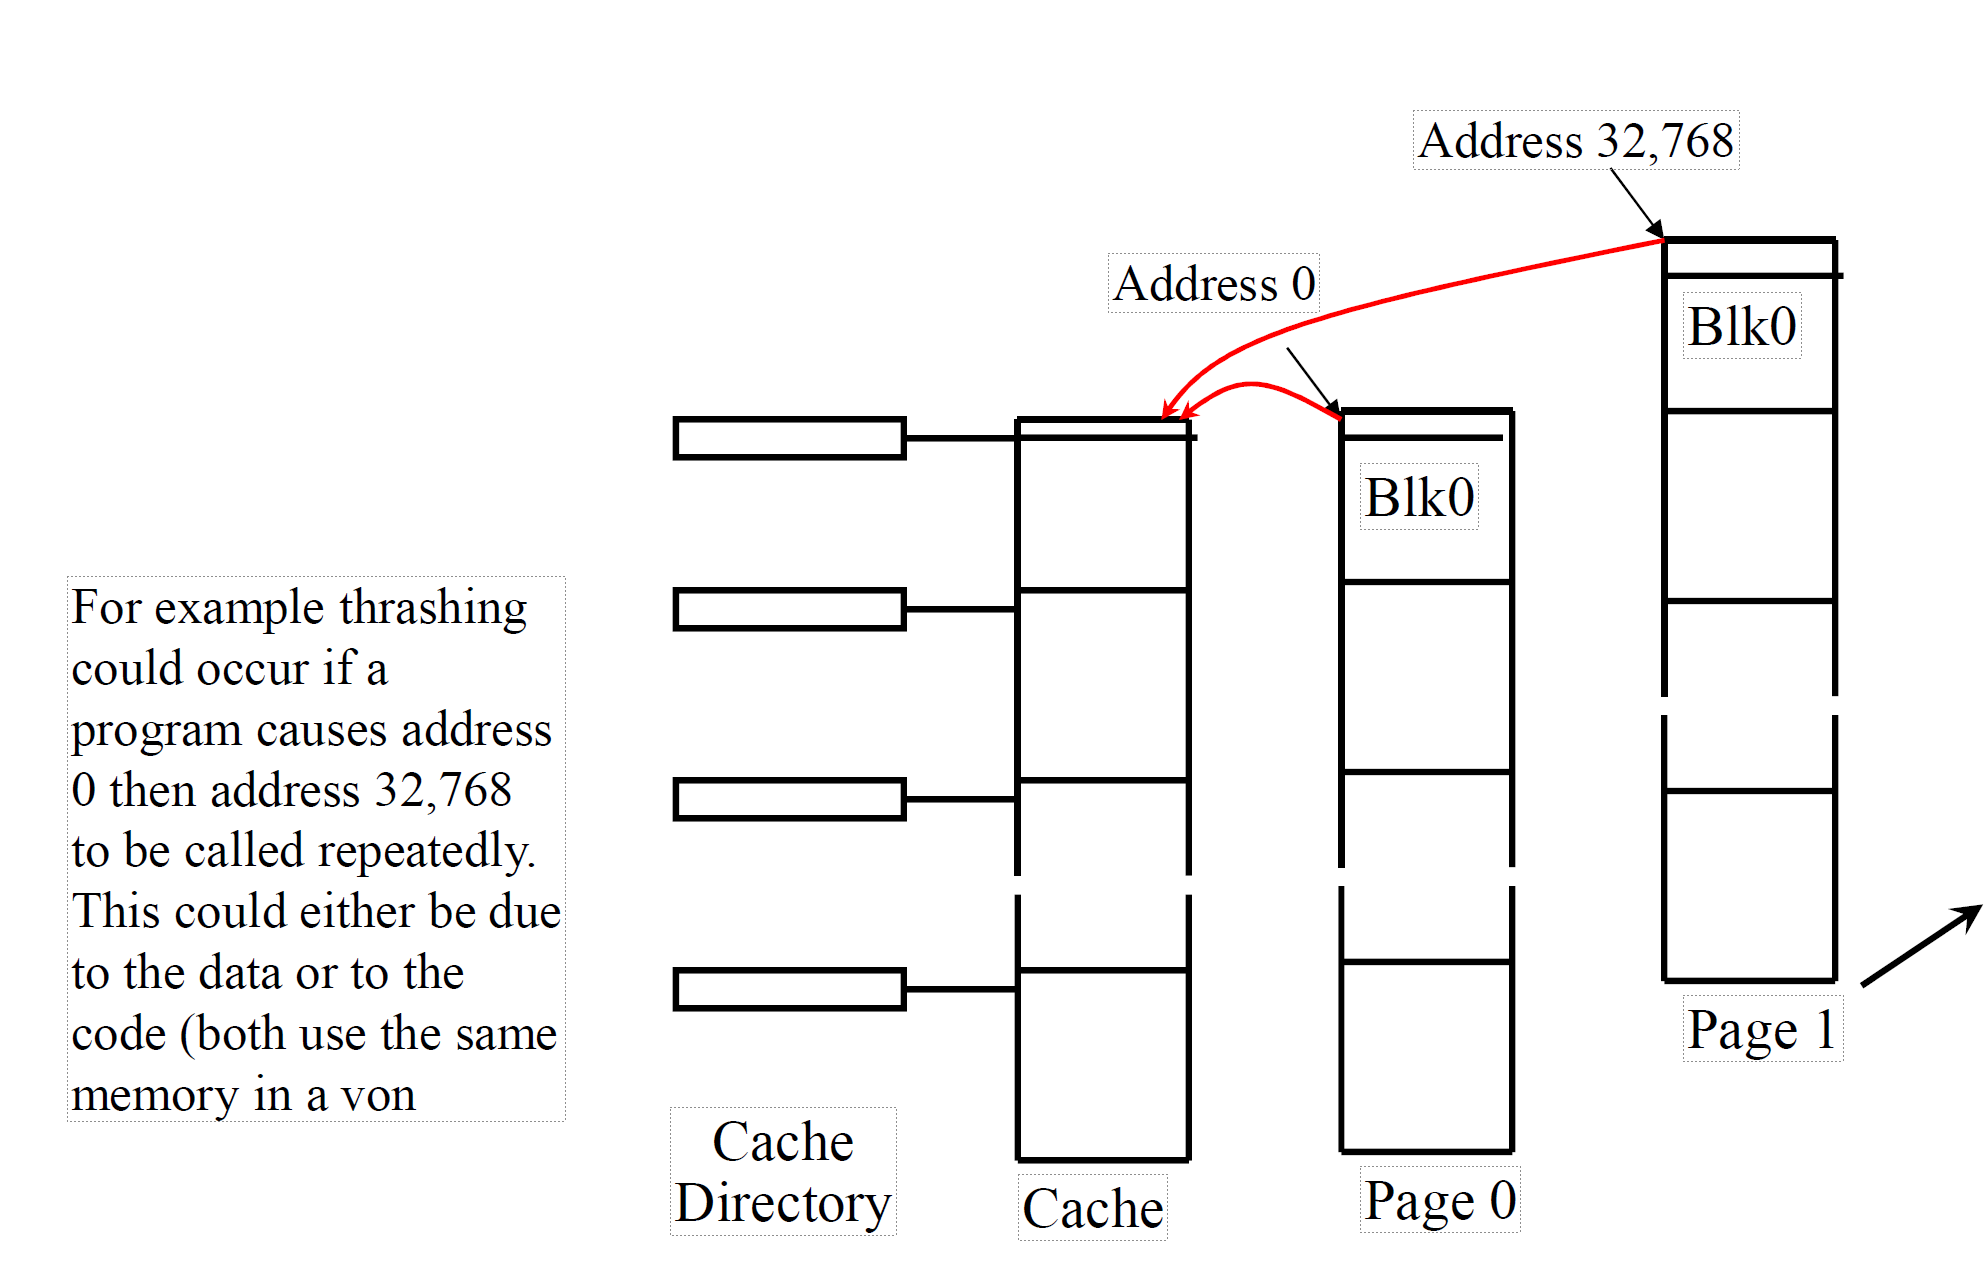
如图,如果先访问 page0 的 blk X,然后 p1 bX,p2 bX,循环下去
每次地址变化都恰好是 32768,就会导致每次访问都刷新一遍缓存,于是导致效率变得很低
二路相联映射 Two-Way Set Associative
- 页数从 131072 变成了 262144,每页的块数减半(从 1024 到 512)
- cache directory 当中的 validity bit 变成了俩,因为有俩缓存
- cache directory 当中新增一个 bit 表示,哪一个是 least recently used 的(LRU)
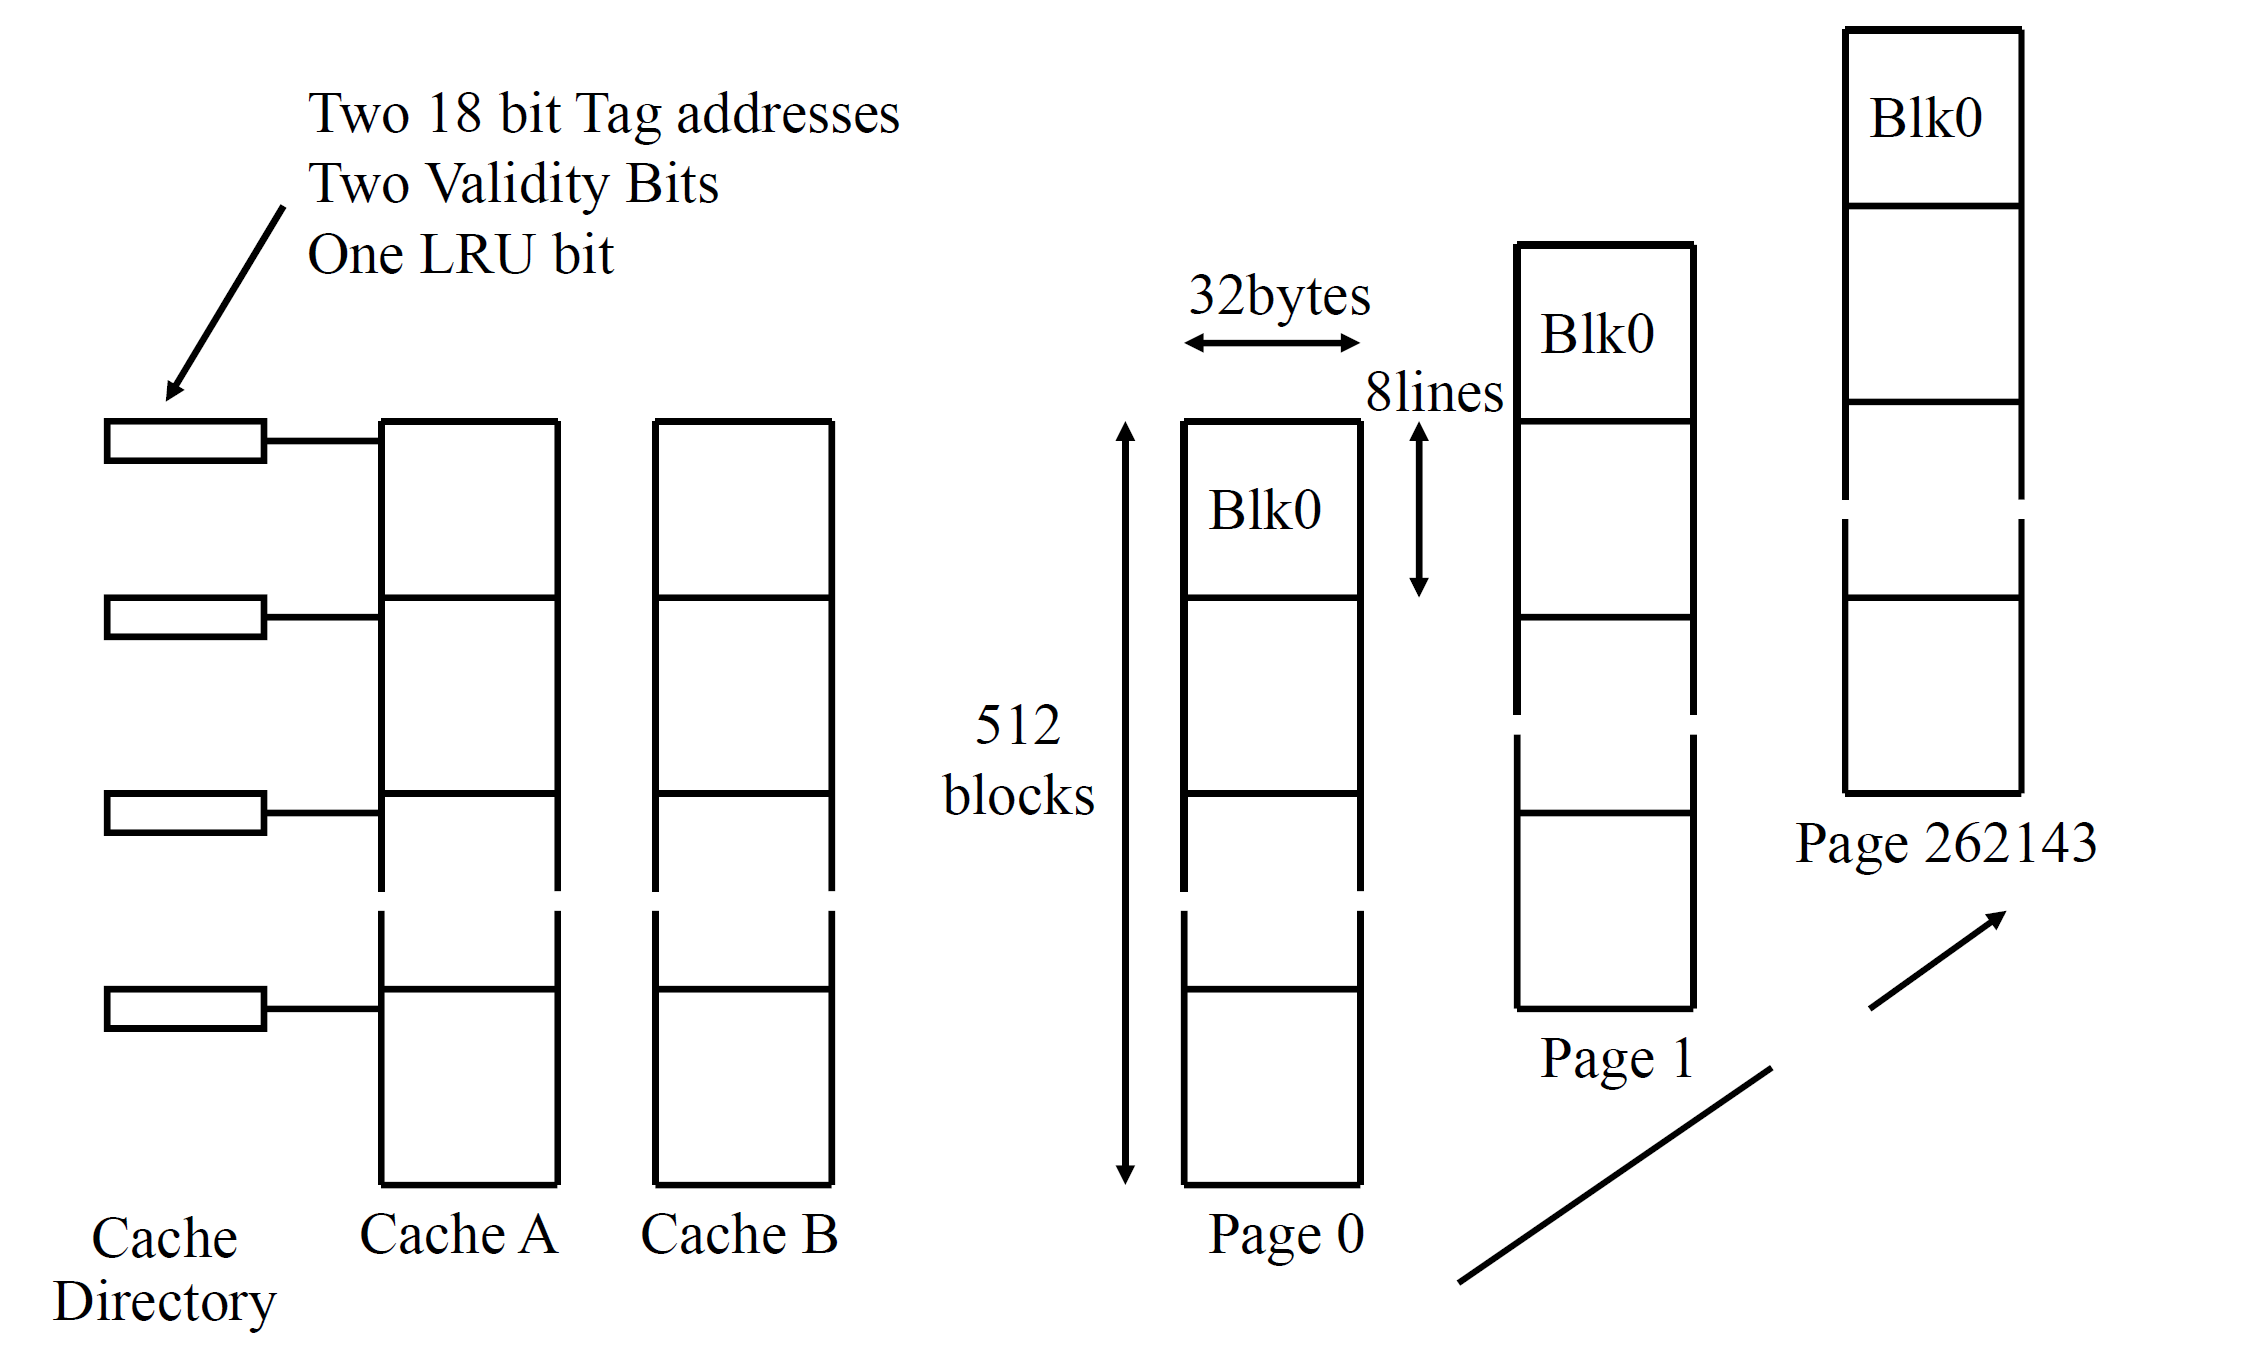
为什么这样可以减少 Thrashing
大概是有两点原因
- 假如缓存 A 已经被占用了,你还可以存到 B 里面
- 假如 AB 都被占用了,你可以根据 LRU 原则,踢掉一个,保留一部分,保留的那些没准就可以减少 miss
全相联映射 Fully Associative
- 每条线(四字节)可以对应缓存的任意位置
- cache directory 当中,tag 必须是 30bits 的
- 正如刚才少说,查找的时候需要遍历
- 当缓存满了,踢掉谁?是随机踢,还是 LRU?
缓存性能
首先考虑什么因素可能导致 miss:
- 某个 block 初次被访问
- 缓存爆满,需要 thrashing
阿姆达尔定律 Amdahl’s Law
阿姆达尔定律,一个计算机科学界的经验法则,因吉恩·阿姆达尔而得名。它代表了处理器并行运算之后效率提升的能力。在这里也可以用来算一算缓存与主存的性能提升。