Lecture 8. Time Complexity 时间复杂性
有些问题,即使理论上是可计算的,但如果需要过量的资源(时间或空间),那么他在实际上就是不可计算的。
大 记法、小 记法
大 记法
定义:设 和 是两个函数,且 ,。若存在正整数 和 ,使得对于所有的 (足够大的 ),满足 ,则称 。当 的时候,称 是 的上界(upper bound),或更准确的叫做 渐进上界(asymptotic upper bound),以强调没有考虑常数因子。
小 记法
定义:设 和 是两个函数,且 ,。称 ,若满足 ,则称 。换句话说,若 ,这意味着对于任何实数 ,都存在一个数 ,使得对于所有的 (足够大的 ),都满足 。
比较
- 大 记法指一个函数渐进的 不大于 另一个函数
- 小 记法指一个函数渐进的 小于 另一个函数。就类似 和 的区别。
几个等式
- =
引入复杂性理论的一个例子
在复杂性方面,我们只考虑可判定的语言。
令 。根据以前的知识,这是一个非正则的上下文无关语言。既然是 CFL,那么就一定是可判定的。问题来了:需要多少步才能够判定这个语言?
显然,随着输入长度 的变化,所需步骤数也会变化。因此我们考虑在输入长度为 的情况下,步骤数量的上界值。所以,这里要使用「大 O 记法」。
之前对于语言 的判定算法是 的。
“对于输入 ,
- 扫描一遍纸带,检查是否是 的形式。这个操作需要 步,然后再把读写头返回到左端点,又是 步。所以总共是 步。所以这个阶段需要 步。
- 不停重复扫描纸带。每次扫描删除一个 和一个 。每次扫描 步,共扫描 次,所以这个阶段需要 步。
- 最后检查纸带,是否有多余的 和 就拒绝。这个检查需要 步。”
因此,总时间是 。
类似地, 也是 的。
优化到
太慢了!刚才这个问题可以优化到 其实。利用奇偶性,可以设计出一个更快的图灵机算法。
“对于输入 ,
- 扫描一遍纸带,检查是否是 的形式。。
- 只要纸带上还有 或 ,就重复以下内容 :
- 扫一遍,统计剩下的 和 的总数。如果是奇数,拒绝。。
- 从第一个 开始,隔一个删一个 。然后从第一个 开始,隔一个删一个 。删完之后, 的个数变成 , 的个数变成 。。
- 最终如果纸带空了,就接受。否则拒绝。”
所以这个新算法是 的。
然而, 无法在单带图灵机的限制下优化到 ,因为 不像 一样可以依次扫描删除一半。
优化到 (线性时间)
不过,显然,如果要写代码来判定这个语言,可以写一个 的做法——扫一遍看是不是 的形式,再看看 和 的个数是否相等就完事儿了。但是这个事情无法直接用单带图灵机实现,需要借助双带图灵机。
“对于输入 ,
- 扫描一号纸带,看是否是 的形式。如果不是直接拒绝。。
- 扫描一号纸带的所有 ,到 停止。然后把一号纸带的所有 复制到二号纸带。。
- 继续扫描一号纸带。每当遇到一号纸带的一个 ,就删掉二号纸带的一个 。如果 被删光了 还没扫完,拒绝。。
- 如果 有剩余,拒绝。如果 恰好删光了,接受。”
所以这个算法是 的。
二级结论
从刚才的比较上来看, 的复杂度与选择的模型(单带还是双带还是啥)有关。虽然在可计算性理论当中,所有判定相同语言类的模型都是等价的,但是在复杂性理论当中,模型的选择会影响到时间复杂度。
单带图灵机在 的时间内能够判定的语言,都是正则语言(注意是小 不是大 )。刚才那个语言(CFG)用单带图灵机最快只能达到 ,所以不是正则语言。这个结论无需掌握证明。可以感性理解:正则语言可以用 DFA 来识别,所以用图灵机来判定正则语言的时候,只要顺着所有的状态走下来一遍就好了。所以正则语言的时间复杂度大约是线性的,比 严格小。
时间复杂性类 Time Complexity Class
定义:函数 ,图灵机 总是会在 步以内停机,则说这个图灵机运行 时间。
定义:定义时间复杂性类 是由 时间的图灵机判定的所有的语言的集合。注意这里是大 不是小 。即:。所以说,时间复杂性类是 语言的集合。
刚才的语言 可以用单带图灵机在 的时间之内判定,所以说 。由于可以换用一个更高效的能在 时间内判定它的单带图灵机,所以还有 。由于 的线性算法需要用两个纸带,所以这里 。
只有正则语言可以属于 。
时间复杂性类之间的关系大概可以这样描述:

模型之间的复杂性关系
多带图灵机 vs 单带图灵机
定理:若存在一个多带图灵机可以在 的时间内判定语言 ,那么就有 。换句话讲,每个 时间的多带图灵机都跟某个 时间的单带图灵机等价。证明思路比较简单。假设 是多带图灵机, 是对应的单带图灵机。由于单带图灵机要在一条纸带上用 把多带图灵机的所有纸带内容分割记录,所以多带图灵机当中的读写头移动一个格子,单带图灵机的读写头可能要从当前片段移动到另一个被 分割的片段。所以, 一步执行的操作, 需要 步。故 需要要 的时间。
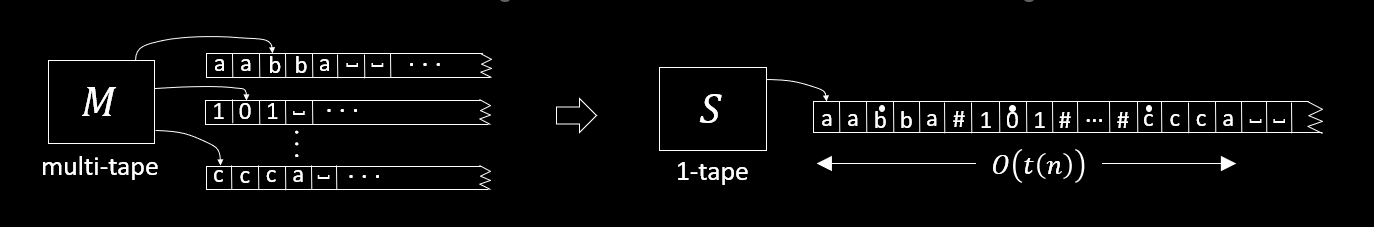
扩展到非确定性图灵机上,也有类似的定理:每个 时间的非确定性多带图灵机都跟某个 时间的单带确定性图灵机等价。
多项式相关 polynomially related
非形式化的定义说,如果存在两个计算模型,能够相互以多项式的开销模拟另外一个,也就是其中一个花费 ,另一个花费 ,则说这两个计算模型是多项式相关的。也叫多项式等价。
所有合理的确定性计算模型(不考虑量子计算),都是多项式相关的。如:
- 单带图灵机
- 多带图灵机
- 多维图灵机
- 随机存储器(random access machine,RAM)
- 细胞自动机(cellular automata)(大概就是有限自动机阵列)
P 类
定义:,也就是所有的确定性单带图灵机在多项式时间内能够判定的 语言 的集合。
对于所有的计算模型,只要与单带确定性图灵机的多项式时间等价,那么 就是不变的。
基本对应着计算机上实际可解的问题类。可以粗略地认为,只要是计算机能解决的,就属于 类。
PATH 路径问题(P)
给定一个有向图 ,判断 中是否包含 到 的路径。即:。。
判定 的图灵机 构造如下:
"对于输入 :
- 标记起点
- 重复以下过程,直到不再有新的被标记的节点()
- 对于每一个已经标记的节点 (),扫描所有的边集(),对于所有的边 ,标记
- 如果 没被标记,拒绝。被标记了,接受"
这像是一个 BFS 算法。时间复杂度是 的。由于单带图灵机的存储功能有限,所以对于每个节点能到达哪里,只能遍历一遍所有的边,不能像常规计算机那样直接读取。
HAMPATH 哈密顿路径问题(不是 P)
。。哈密顿路径要经过每一个节点,且每一个节点恰好被经过一次(欧拉路径是啥来着?)。
判定 的图灵机 构造如下:
"对于输入 :
- 设图中一共有 个节点
- 对于图中每一个长度为 的路径():
- 检查这个路径是否是从 到 的。如果是,接受;否则继续
- 拒绝"
于是这个算法的时间复杂度是 的,指数级别。不能在多项式时间内解决。所以 。